
 맞춤추천



공동활용장비

- 장비찾기
- 공동활용장비
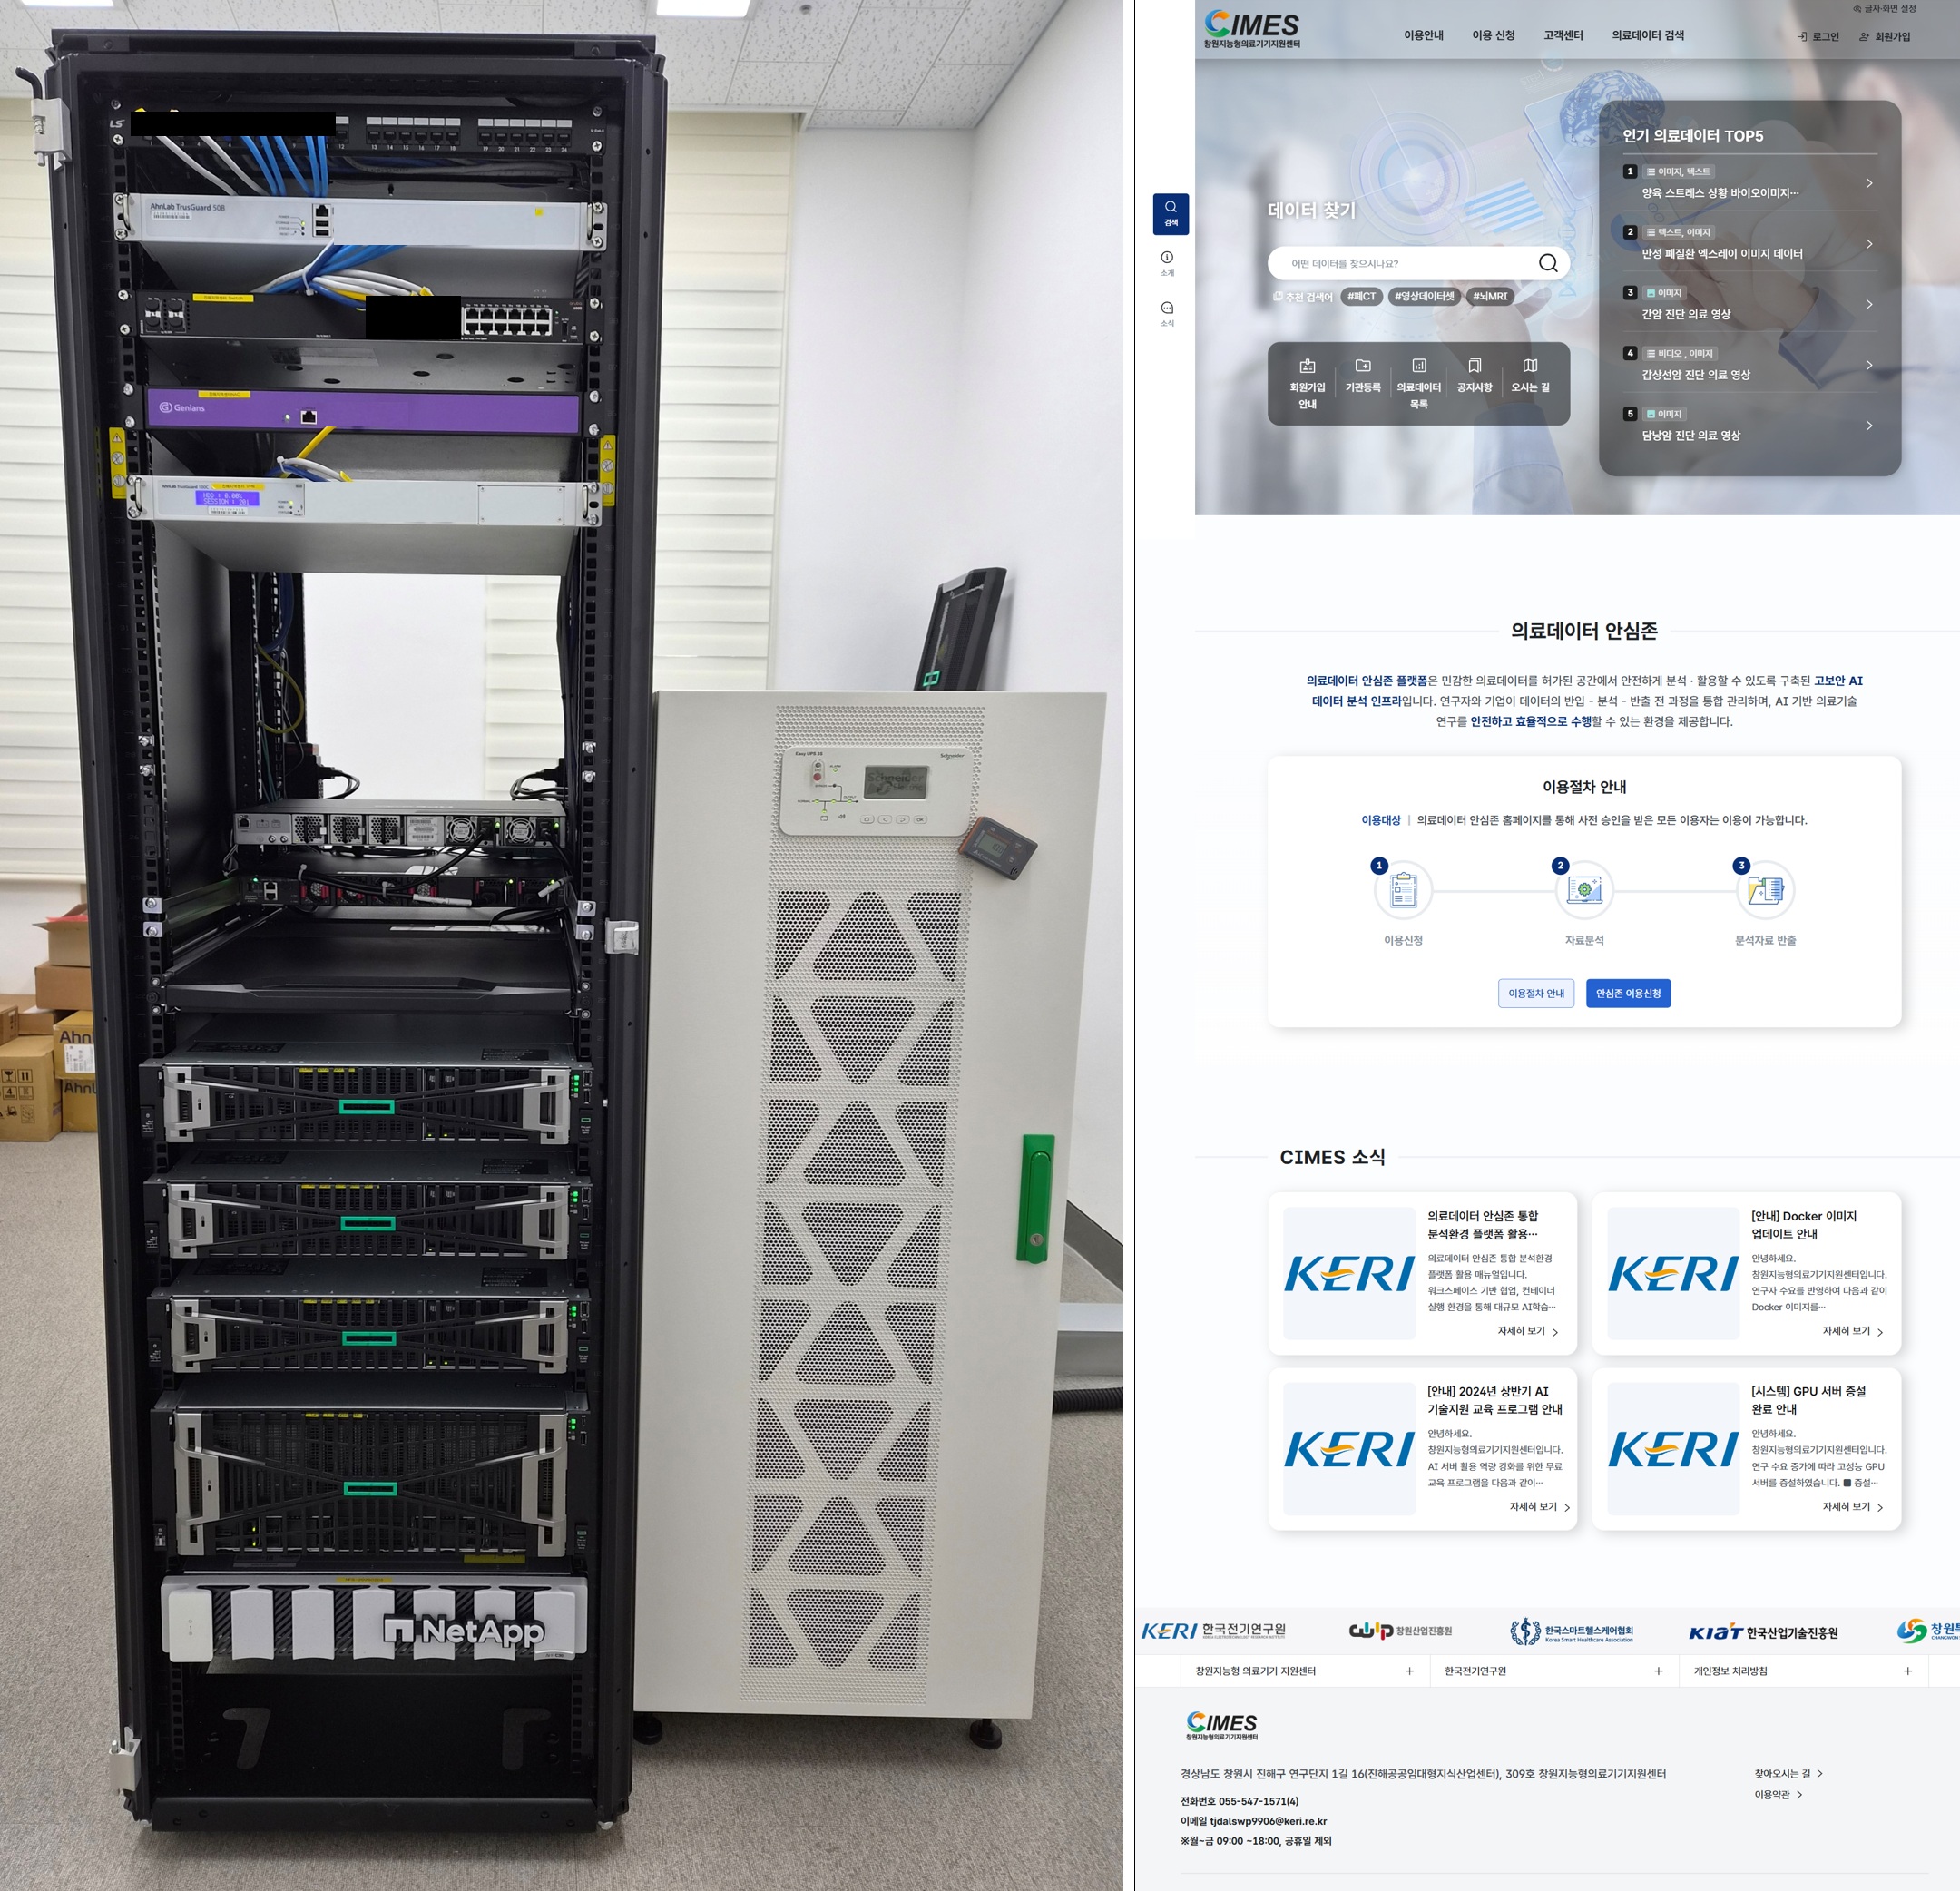
- Secure Medical Data Zone Platform
- 의료 데이터 안심존 플랫폼
- i-Tube No. 2603-E-0005
- NTIS No
- 설치기관 한국전기연구원
- 주소 경상남도 창원시 진해구 연구단지1길 16 (여좌동)
- 담당자 김민규 (T. 055-280-1568 )
- 매뉴얼
-
온라인* 본 장비는 온라인 예약이 불가하오니 장비사용 예약과 관련해서는
예약가능여부
장비 보유기관에 직접 문의 주시기 바랍니다. (장비 예약은 Zeus 시스템에서 회원가입후 예약가능)
장비정보
-
제작사
HPE
-
모델 명
HPE DL380a Gen12 GPU SERVER
내용연수6년
-
구분
주장비
용도분석
-
표준 분류
데이터처리장비 > 하드웨어 > 고성능컴퓨터
장비활용범위공동활용서비스
-
취득일
2026-03-06
취득금액1,131,500,400원
-
인증정보
없음
-
기능
1) GPU 연산 라이브러리를 이용한 객체 탐지 모델 지원
GPU 서버의 H200 GPU는 CUDA 기반 병렬 연산 구조를 활용하여 대규모 행렬 연산을 지원하며 대용량 영상 데이터를 읽고 전처리한 후, YOLOv8 기반 인공지능 모델을 이용한 객체 탐지 및 추론 기능을 통하여 분석 결과를 빠르게 재구성하고 시각화
2) 대규모 영상의 전처리과정을 통한 데이터셋 생성
CUDA 병렬연산, HBM3e, NVLink 기술을 기반으로 영상 데이터에 대해 해상도 조정, 픽셀 값 정규화, 노이즈 제거, 영상 보정, 크롭, 패딩 등의 전처리 연산을 수행하고, 영상 데이터의 품질을 균일하게 맞추어 학습 데이터셋 생성하여 모델이 학습하기 쉬운 형태로 데이터를 정제하는 기능을 지원
3) 신경망 모델의 학습을 위한 초고대역폭 메모리 지원
초고대역폭(HBM3e) 메모리는 대량의 데이터와 모델 파라미터를 GPU 메모리에 빠르게 적재하고 처리할 수 있도록 지원하여 대규모 신경망 연산 시 데이터 병목 현상을 줄이고 대용량 학습 데이터의 고속 로딩, 대규모 모델 파라미터 처리, 미니배치 기반 학습 수행, 다중 GPU 기반 병렬 및 분산 학습 처리를 지원
4) NVLink을 통한 GPU 간의 직접 연결 지원
NVLink를 활용하여 GPU 간 파라미터 동기화, 텐서 데이터 교환, 모델 분산 학습의 고속 처리하는 기능을 제공하며, 다수의 GPU 간 데이터를 초고속으로 전달할 수 있는 병렬 처리 환경을 제공
5) GPU 자원 관리 및 공유
GPU 솔루션은 컨테이너 기반 가상화 기술인 도커를 활용하여 사용자별 분석 환경을 독립적으로 제공하고, GPU 자원의 할당 및 사용 현황을 체계적으로 관리 -
장비 상세설명
1) GPU 서버
- 성능 : HPE DL380a Gen12, CPU 3.6GHz, 32코어, 메모리 2048GB, H200 GPU*4
- GPU 서버는 대규모 데이터 처리와 딥러닝 연산을 효율적으로 수행할 수 있도록 구성된 고성능 컴퓨팅 장비이다. 다수의 사용자가 동시에 딥러닝 연산을 수행할 수 있으며 최대 4명의 연구자가 동시에 GPU 자원을 활용할 수 있는 연구 환경을 제공한다.
2) 대용량 저장장치
- 성능 : C30 NVMe QLC 15.3TB *16
- 대용량 저장장치는 고성능 대용량 스토리지 시스템이며 총 약 172TiB의 사용 가능 저장 용량을 제공하여 의료 데이터 저장하고 NFS 환경으로 구성된다. NVMe 기반의 고속 데이터 입출력 성능을 바탕으로 대용량 의료 이미지, 영상, 음성 정보와 같은 다양한 형태의 의료 데이터를 안정적으로 저장한다.
3) 응용시스템 서버
- 성능 : HPE DL380 Gen11, CPU 3.9GHz, 16코어, 메모리 64GB
- 응용시스템 서버는 GPU 관리 솔루션과 운영관리 시스템을 구동하기 위한 서버로, 사용자 및 관리자용 웹 서비스와 웹 애플리케이션, 데이터베이스 등을 안정적으로 운영하기 위한 시스템 인프라를 제공한다.
4) 운영관리시스템
-데이터 안심존 운영관리시스템은 의료데이터의 안전한 이용과 체계적인 관리 운영을 지원하기 위한 관리자용 정보시스템으로, 통합 관리 포털 시스템, 메타데이터 관리 시스템, 데이터 반입 및 반출 관리 시스템 등으로 구성된 운영 관리 플랫폼이다.
5) GPU 관리솔루션
- 제품명 : AstraGo 1.0
- GPU 관리 솔루션은 쿠버네티스 기반의 GPU 클러스터 관리 및 최적화 솔루션이며, 도커 기반 운영 환경을 통하여 분석도구 지원, 자원 현황 관리, 컴퓨팅 자원 공유를 위한 관리자 및 사용자 인터페이스를 제공한다.
이용안내
-
사용형태
기관의뢰 직접사용
설치형태고정형
-
사용료 형태
건별
장비 사용료[EA] 100,000원
장비설명
의료데이터 안심존 플랫폼은 고성능 GPU 서버와 NVIDIA H200 GPU를 활용한 GPU 가속 컴퓨팅 환경을 구축하여 의료데이터 분석 및 인공지능 연구를 지원하는 통합 분석 인프라이다. 고성능 CPU와 대용량 메모리, 고속 스토리지 환경을 기반으로 안정적인 데이터 처리 성능을 제공하며, NVIDIA H200 GPU의 대규모 병렬 연산 성능과 대용량 HBM 메모리를 활용하여 인공지능 모델 학습, 대규모 의료데이터 분석, 의료영상 처리 등 고성능 연산 작업을 효율적으로 수행할 수 있다.
GPU 자원의 효율적인 활용을 위하여 GPU 관리 솔루션을 구축하여 다수의 사용자와 연구자가 GPU 자원을 공유할 수 있는 환경을 제공한다. 해당 솔루션은 GPU 자원 할당 및 스케줄링, 사용 현황 모니터링, 컨테이너 기반 분석 환경 제공 등을 통해 연구자별 분석 환경을 분리하고 GPU 자원을 효율적으로 관리할 수 있도록 지원한다. 이를 통해 다양한 의료데이터 분석 및 인공지능 연구를 안정적으로 수행할 수 있는 GPU 기반 분석 환경을 제공한다.
운영관리 시스템을 구축하여 의료데이터 분석 환경의 통합 관리가 가능하며 분석 신청 및 승인 관리, 사용자 계정 및 권한 관리, 데이터 반입·반출 관리, 분석 이력 관리, 시스템 운영 현황 모니터링 등의 기능을 제공하여 의료데이터 분석 환경을 체계적으로 관리할 수 있도록 구축되어 있다. 이를 통해 연구자와 기업은 의료데이터를 활용한 인공지능 모델 개발 및 분석 연구를 효율적으로 수행할 수 있으며, 관리자는 시스템 운영 상태 및 자원 사용 현황을 통합적으로 관리할 수 있다.
통합 GPU 분석 인프라를 통해 의료영상 분석, 의료 빅데이터 분석, 질병 예측 모델 개발 등 다양한 의료 인공지능 연구를 지원하고, 의료데이터 기반 정밀의료 및 헬스케어 기술 개발을 고성능 컴퓨팅 자원와 통합관리시스템으로 구성되어 있다.
장비 구성 및 성능
1) GPU 서버
- 성능 : HPE DL380a Gen12 6724P X3.6GHz*2P/16Core, 2048GB Memory, 1.92TB*2 NVMe SSD, NIC 1G 4P*1, NIC 10/25G SX 2P*1(10Gb SFP), 100Gb 2P*1, H200 GPU*4EA
2) 대용량 저장장치
- 성능 : C30 NVMe NVMe QLC 15.3TB * 16ea (usable 172TiB), NIC 100GB SFP 4port,Ontap One, NIC 10GB SFP 4port
3) 응용시스템 서버
- 성능 : HPE DL380 Gen11 Gold6534 X3.9GHz*2P/8Core, 64GB Memory, 960GB*2 SSD, NIC 1G TX 4P*1, NIC 10/25G 2P*1(10G Transiver ), Power*2
4) 운영관리시스템
-데이터 안심존 운영관리시스템은 의료데이터의 안전한 이용과 체계적인 관리 운영을 지원하기 위한 관리자용 정보시스템으로, 통합 관리 포털 시스템, 메타데이터 관리 시스템, 데이터 반입 및 반출 관리 시스템 등으로 구성된 운영 관리 플랫폼이다. 웹 서비스 환경에서 데이터 이용 신청, 심의, 데이터 반입 및 반출 관리, 이용 이력 관리 등을 통합적으로 관리하고 의료데이터 활용 과정 전반에 대한 관리와 통제를 수행한다.
5) GPU 관리솔루션
- AstraGo(GPU 관리 솔루션)는 도커 기반 구성으로 CUDA, Python, Pytouch, 의료영상 분석 라이브러리, 머신러닝 프레임워크, 데이터 처리 패키지 등을 사전에 포함한 컨테이너 이미지를 구성하며, 워크스페이스에 CPU, 메모리, GPU 자원을 분할하고 워크로드(Docker)에서 다양한 분석 도구를 사용할 수 있다.
서울특별시 강남구 테헤란로 305 한국기술센터 2~7, 14층, 16~17층, 21층
i-Tube 대표문의 : 1811-9126 / KIAT 대표 콜센터 : 02-6009-3000
Copyrightⓒ 2020 KIAT All rights reserved.
