
 맞춤추천



공동활용장비

- 장비찾기
- 공동활용장비
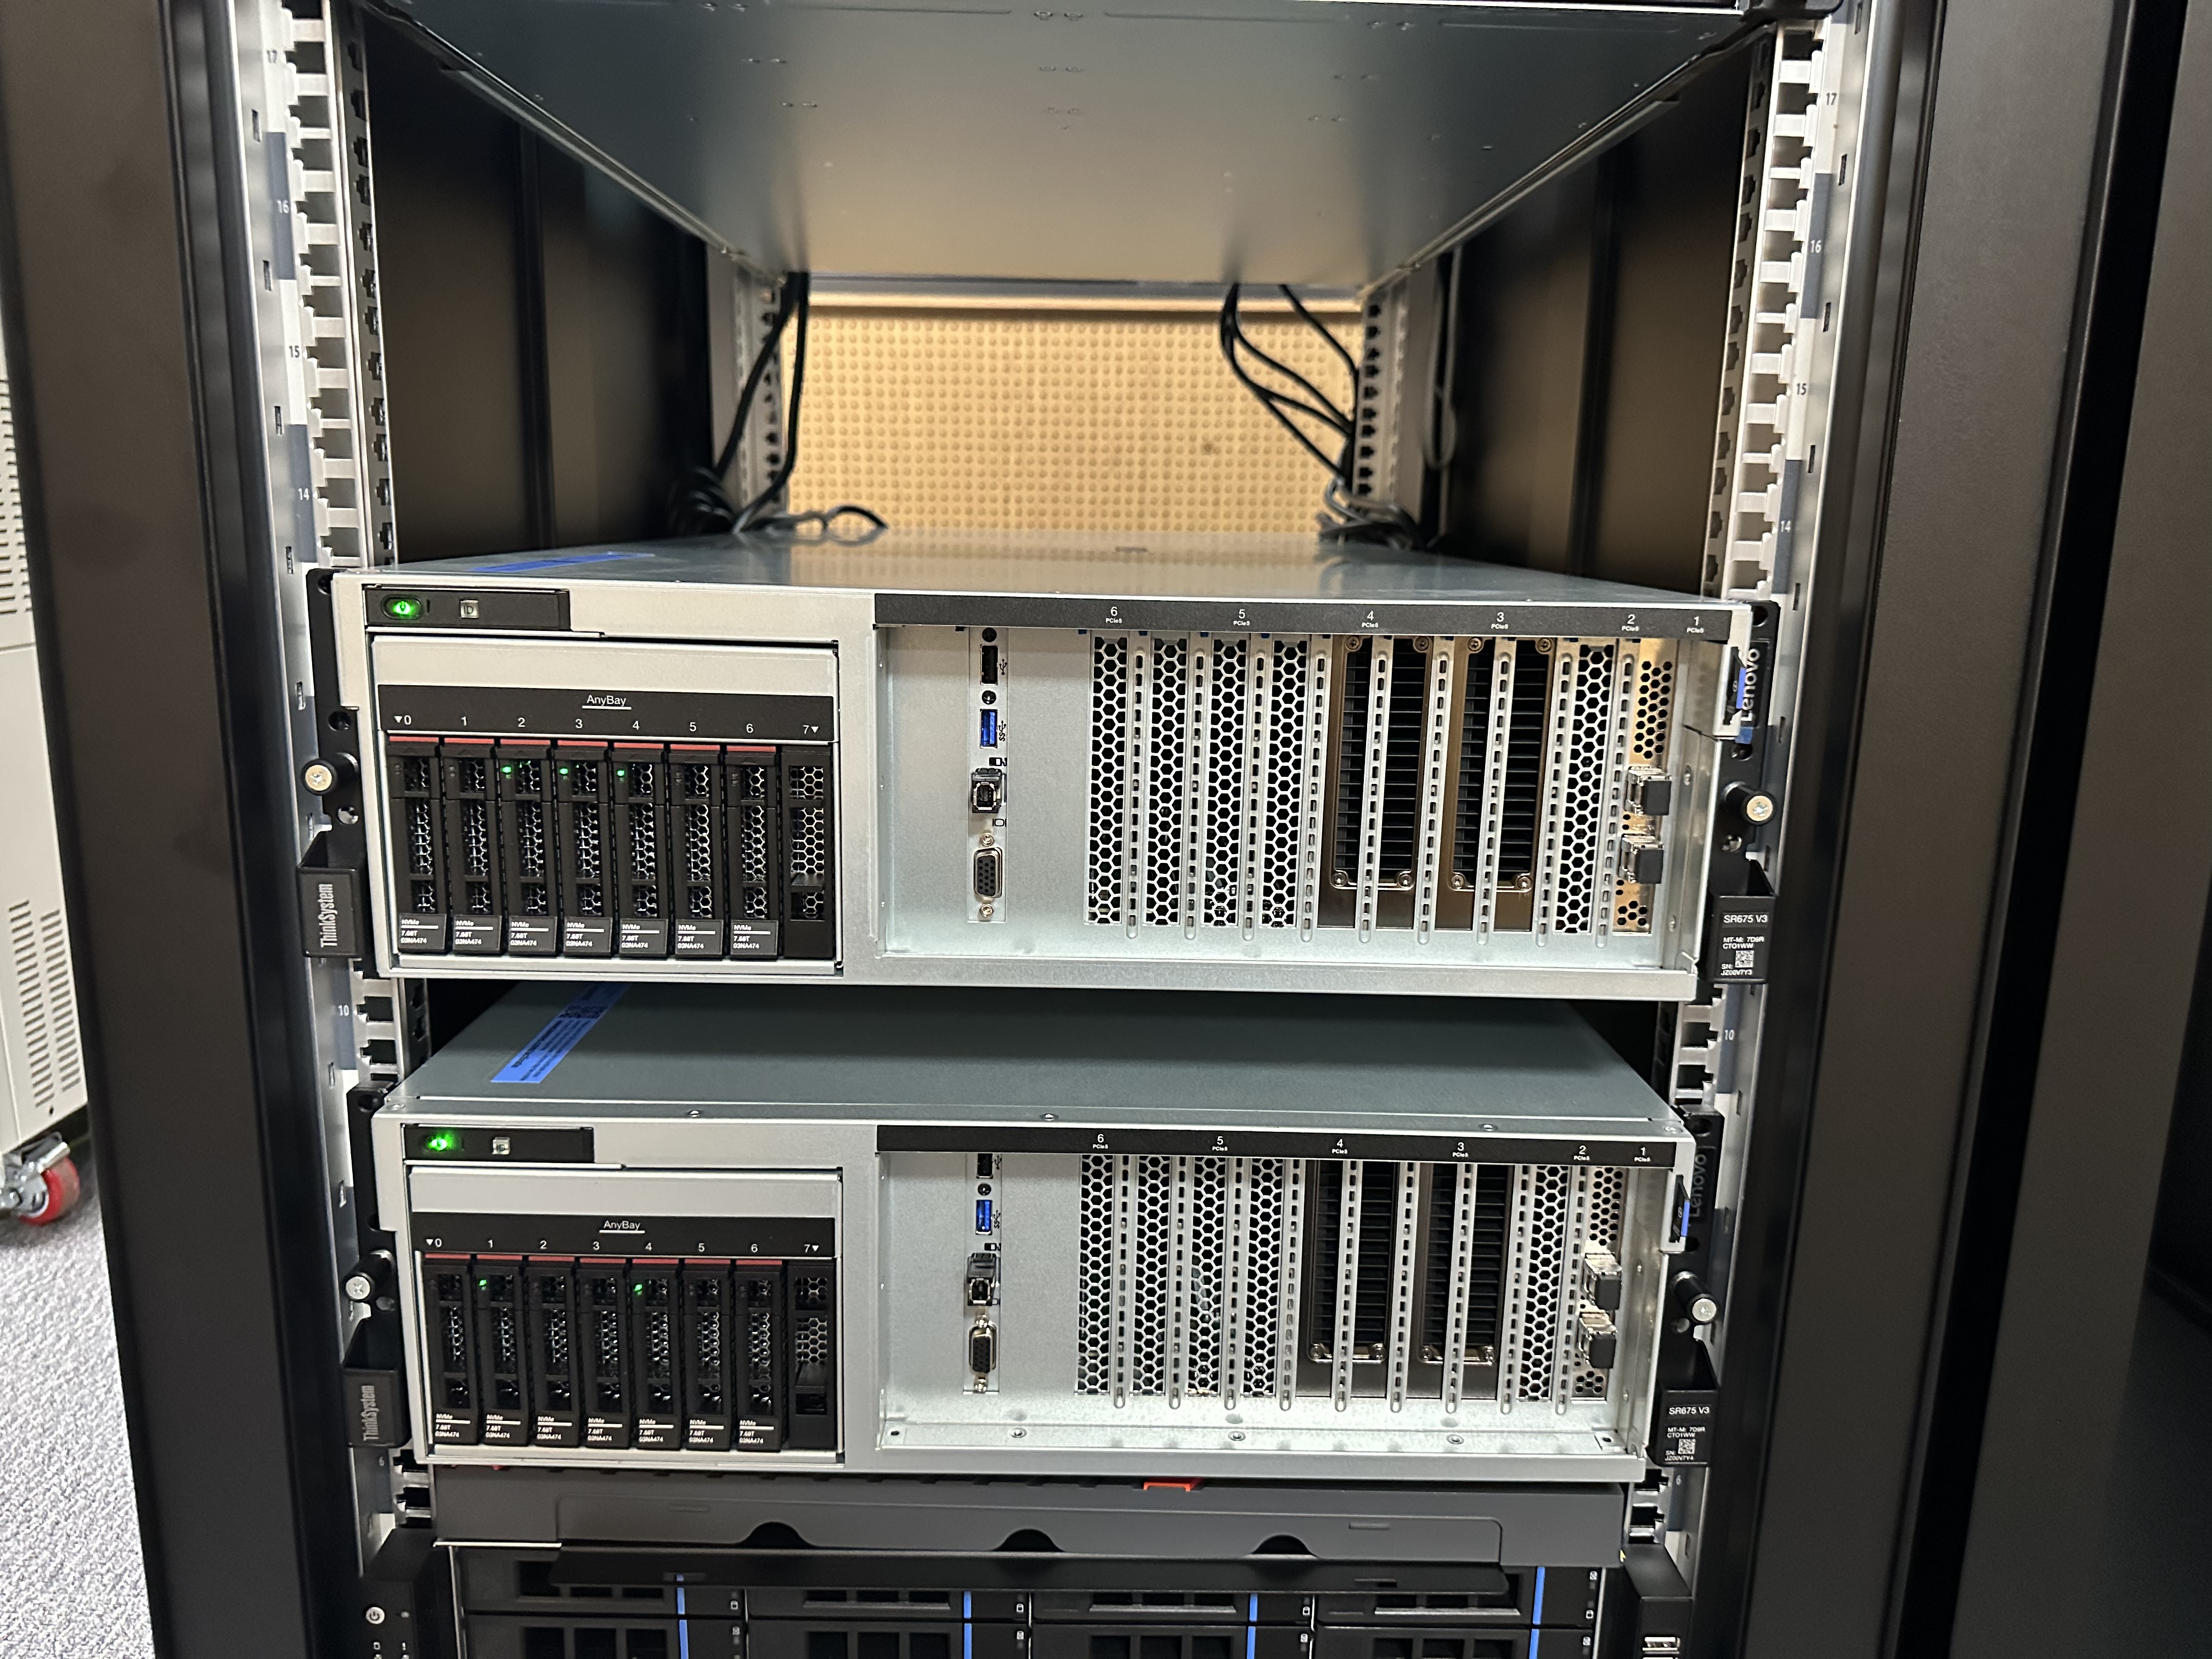
- Data AnalysisGPU Server
- 데이터 분석(GPU) 서버
- i-Tube No. 2509-E-0051
- NTIS No
- 설치기관 재단법인춘천바이오산업진흥원
- 주소 강원특별자치도 춘천시 소양강로 32 (후평동)
- 담당자 이주형 (T. 033-258-6931 )
- 매뉴얼
-
온라인* 본 장비는 온라인 예약이 불가하오니 장비사용 예약과 관련해서는
예약가능여부
장비 보유기관에 직접 문의 주시기 바랍니다. (장비 예약은 Zeus 시스템에서 회원가입후 예약가능)
장비정보
-
제작사
Lenovo
-
모델 명
- Lenovo ThinkSysterm SR675 V3
내용연수10년
-
구분
주장비
용도분석
-
표준 분류
데이터처리장비 > 하드웨어 >
장비활용범위공동활용서비스
-
취득일
2025-09-10
취득금액226,531,890원
-
인증정보
없음
-
기능
기업용 AI/HPC 통합 플랫폼: 딥러닝·머신러닝·HPC·시각화·렌더링·비디오 트랜스코딩 등 가속화 워크로드에 최적화된 모듈식 서버.
모듈식 확장성(EveryScale): 동일 섀시에서 PCIe형 다중 GPU, 고밀도형(PCIe 스위치 기반), HGX(SXM5) 등 다양한 전면/후면 옵션을 조합해 요구에 맞게 구성.
최신 가속기 지원: NVIDIA H100(텐서 코어), Lovelace/Ampere 계열 및 AMD Instinct MI 시리즈까지 선택 가능. H100의 MIG(최대 7분할) 로 멀티사용자·멀티잡 환경 구현.
고효율 냉각: 공랭+액랭 하이브리드 Lenovo Neptune™ 옵션(HGX 구성)으로 높은 발열의 GPU를 안정적으로 냉각(배관 추가 없이 폐쇄 루프 방식), ASHRAE A2 범위 지원.
관리/오케스트레이션: XClarity Controller 2(XCC2), Confluent, Lenovo LiCO 기반 웹 포털로 AI/HPC 워크로드의 제출·모니터링·오케스트레이션 단순화.
클러스터 확장: 고속 패브릭 기반 클러스터로 손쉽게 수평 확장(예: 13대 랙 구성 시 최대 ~2 PFLOPS 수준의 연산력 제시).
폭넓은 OS/가상화 지원: RHEL, SLES, Windows Server, VMware ESXi, Alma/Rocky, Ubuntu 검증. -
장비 상세설명
폼팩터/전원: 3U 랙형. N+N 이중화 4PSU(최대 2600W, Titanium 효율)로 고가용성 전원 구성.
프로세서/메모리: 4세대 AMD EPYC(1~2소켓), DDR5 24 DIMM, 최대 3TB, 4800MT/s.
가속기 슬롯: 구성에 따라 최대 8개의 FHFL 더블와이드 GPU(PCIe Gen5 x16) 또는 HGX H100 4-GPU(SXM5, NVLink 연결).
스토리지
기본형: 최대 8× 2.5“ 핫스왑 SAS/SATA/NVMe
고집적형: 최대 6× EDSFF E1.S NVMe 또는 최대 4× EDSFF E3.S 1T NVMe HS
HGX형: 최대 4× 2.5“ NVMe 또는 최대 4× E3.S 1T NVMe HS
I/O/네트워킹: PCIe Gen5 x16 어댑터 최대 6개(전면 2/후면 4) + OCP NIC 3.0(x16/x8/x4) 1개(구성별), 전·후면 고속 네트워킹 선택 가능.
관리/소프트웨어 스택: XCC2, Confluent, Lenovo HPC/AI 소프트웨어 스택 및 LiCO 웹 포털 지원(클러스터·워크로드 관리 단순화).
냉각: 공랭 기본, Neptune™ 하이브리드 액체-기체 열교환(HGX H100 타깃)로 고발열 GPU 냉각 최적화.
이용안내
-
사용형태
기관의뢰
설치형태고정형
-
사용료 형태
시간별
장비 사용료[Hr] 40,000원
장비설명
폼팩터/전원: 3U 랙형. N+N 이중화 4PSU(최대 2600W, Titanium 효율)로 고가용성 전원 구성.
프로세서/메모리: 4세대 AMD EPYC(1~2소켓), DDR5 24 DIMM, 최대 3TB, 4800MT/s.
가속기 슬롯: 구성에 따라 최대 8개의 FHFL 더블와이드 GPU(PCIe Gen5 x16) 또는 HGX H100 4-GPU(SXM5, NVLink 연결).
스토리지
기본형: 최대 8× 2.5“ 핫스왑 SAS/SATA/NVMe
고집적형: 최대 6× EDSFF E1.S NVMe 또는 최대 4× EDSFF E3.S 1T NVMe HS
HGX형: 최대 4× 2.5“ NVMe 또는 최대 4× E3.S 1T NVMe HS
I/O/네트워킹: PCIe Gen5 x16 어댑터 최대 6개(전면 2/후면 4) + OCP NIC 3.0(x16/x8/x4) 1개(구성별), 전·후면 고속 네트워킹 선택 가능.
관리/소프트웨어 스택: XCC2, Confluent, Lenovo HPC/AI 소프트웨어 스택 및 LiCO 웹 포털 지원(클러스터·워크로드 관리 단순화).
냉각: 공랭 기본, Neptune™ 하이브리드 액체-기체 열교환(HGX H100 타깃)로 고발열 GPU 냉각 최적화.
장비 구성 및 성능
(A) 기본 모듈(PCIe, 범용 가속)
형태: 최대 4× FHFL 더블와이드 GPU(PCIe Gen5 x16) + 최대 8× 2.5“ 핫스왑 스토리지.
특징: 범용 DL/HPC, 데이터 전처리·학습·추론을 한 섀시에서 균형 있게 수행. 스토리지 확장성이 좋아 로컬 스크래치/캐시 용도에 유리.
성능 포인트: 최신 EPYC + PCIe Gen5로 대역폭 향상. 멀티 GPU 병렬 학습 및 데이터 병렬/모델 병렬 구성 용이.
(B) 집약적 모듈(고밀도 PCIe, 8GPU)
형태: PCIe 스위치 기반 최대 8× FHFL 더블와이드 GPU(각 x16) + E1.S/E3.S NVMe(초고속 로컬 스크래치).
특징: 단일 노드 내 8GPU로 대규모 배치 학습·파인튜닝·대형 모델 추론에 최적. 고밀도이면서도 전면/후면 네트워킹 옵션으로 분산 학습의 스케일아웃 용이.
(C) HGX 모듈(SXM5, NVLink)
형태: NVIDIA HGX™ H100 4-GPU(SXM5, NVLink 연결) + 최대 4× NVMe(E3.S/2.5“).
특징: NVLink 고대역폭으로 모델 병렬/파이프라인 병렬 효율 극대화. Neptune™ 하이브리드 냉각으로 지속적인 고부하 워크로드 안정성 확보.
성능 포인트: H100 MIG 로 GPU 1장을 최대 7인스턴스로 논리 분할 → 다수 사용자/서비스 동시 처리. 13대 랙 ≈ ~2 PFLOPS 참고치.
서울특별시 강남구 테헤란로 305 한국기술센터 2~7, 14층, 16~17층, 21층
i-Tube 대표문의 : 1811-9126 / KIAT 대표 콜센터 : 02-6009-3000
Copyrightⓒ 2020 KIAT All rights reserved.
